[开源]企业级本地知识库问答解决方案 任意格式文件或数据库的问答

一、开源项目简介
万物皆可问
开源的企业级本地知识库问答解决方案,致力于支持任意格式文件或数据库的问答。
什么是QAnything?
QAnything (Question and Answer based on Anything) 是致力于支持任意格式文件或数据库的本地知识库问答系统,可断网安装使用。
您的任何格式的本地文件都可以往里扔,即可获得准确、快速、靠谱的问答体验。
目前已支持格式: PDF(pdf),Word(docx),PPT(pptx),XLS(xlsx),Markdown(md),电子邮件(eml),TXT(txt),图片(jpg,jpeg,png),CSV(csv),网页链接(html)。
二、开源协议
使用Apache-2.0开源协议
三、界面展示


四、功能概述
特点
-
数据安全,支持全程拔网线安装使用。
-
支持跨语种问答,中英文问答随意切换,无所谓文件是什么语种。
-
支持海量数据问答,两阶段向量排序,解决了大规模数据检索退化的问题,数据越多,效果越好。
-
高性能生产级系统,可直接部署企业应用。
-
易用性,无需繁琐的配置,一键安装部署,拿来就用。
-
支持选择多知识库问答。
五、技术选型
架构
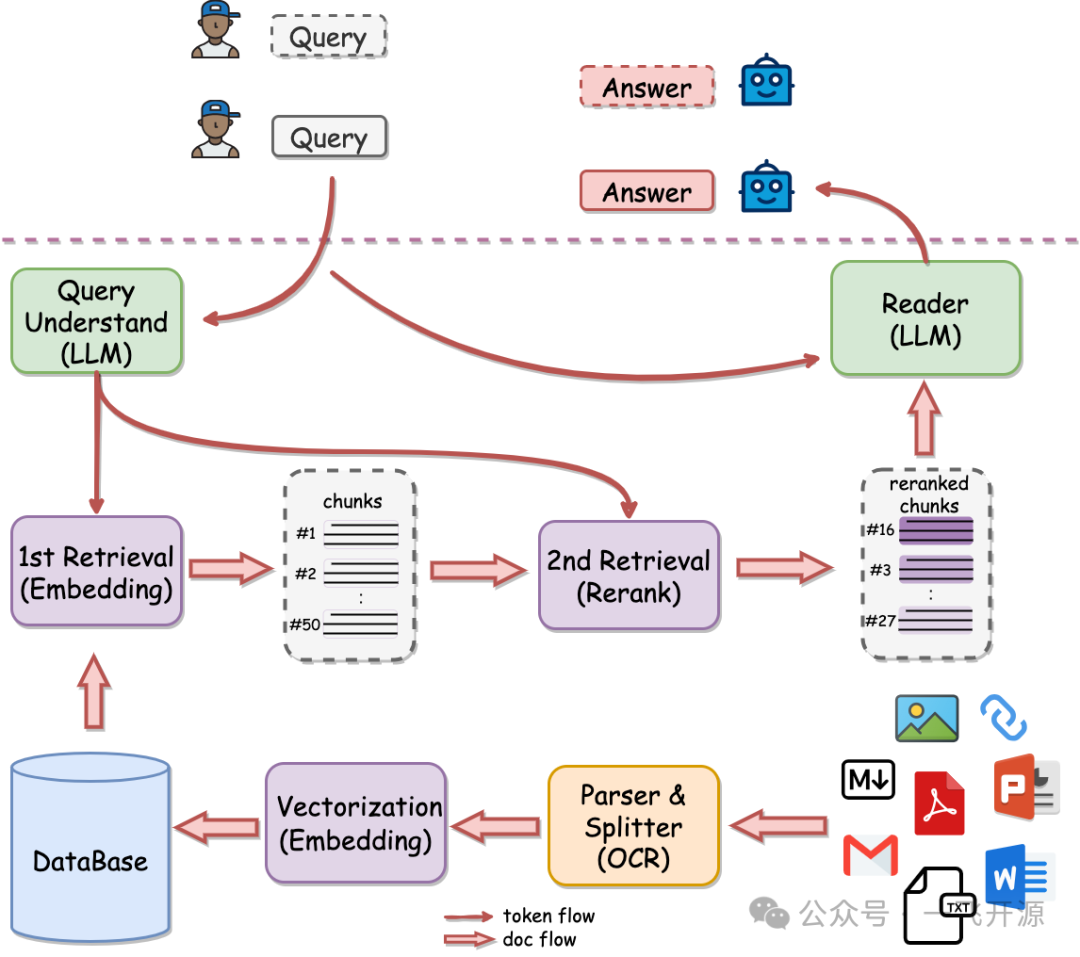
为什么是两阶段检索?
知识库数据量大的场景下两阶段优势非常明显,如果只用一阶段embedding检索,随着数据量增大会出现检索退化的问题,如下图中绿线所示,二阶段rerank重排后能实现准确率稳定增长,即数据越多,效果越好。

LLM
开源版本QAnything的大模型基于通义千问,并在大量专业问答数据集上进行微调;在千问的基础上大大加强了问答的能力。如果需要商用请遵循千问的license,具体请参阅:通义千问。
开始
必要条件
For Linux
|
System |
Required item |
Minimum Requirement |
Note |
|
Linux |
NVIDIA GPU Memory |
>= 4GB (use OpenAI API) |
最低: GTX 1050Ti(use OpenAI API) |
|
NVIDIA Driver Version |
>= 525.105.17 |
||
|
Docker version |
>= 20.10.5 |
Docker install |
|
|
docker compose version |
>= 2.23.3 |
docker compose install |
|
|
git-lfs |
git-lfs install |
For Windows with WSL Ubuntu子系统
|
System |
Required item |
Minimum Requirement |
Note |
|
Windows with WSL Ubuntu子系统 |
NVIDIA GPU Memory |
>= 4GB (use OpenAI API) |
最低: GTX 1050Ti(use OpenAI API) |
|
GEFORCE EXPERIENCE |
>= 546.33 |
GEFORCE EXPERIENCE download |
|
|
Docker Desktop |
>= 4.26.1(131620) |
Docker Desktop for Windows |
|
|
git-lfs |
git-lfs install |
更多内容请查看 README.md 文档